 徐万新之路
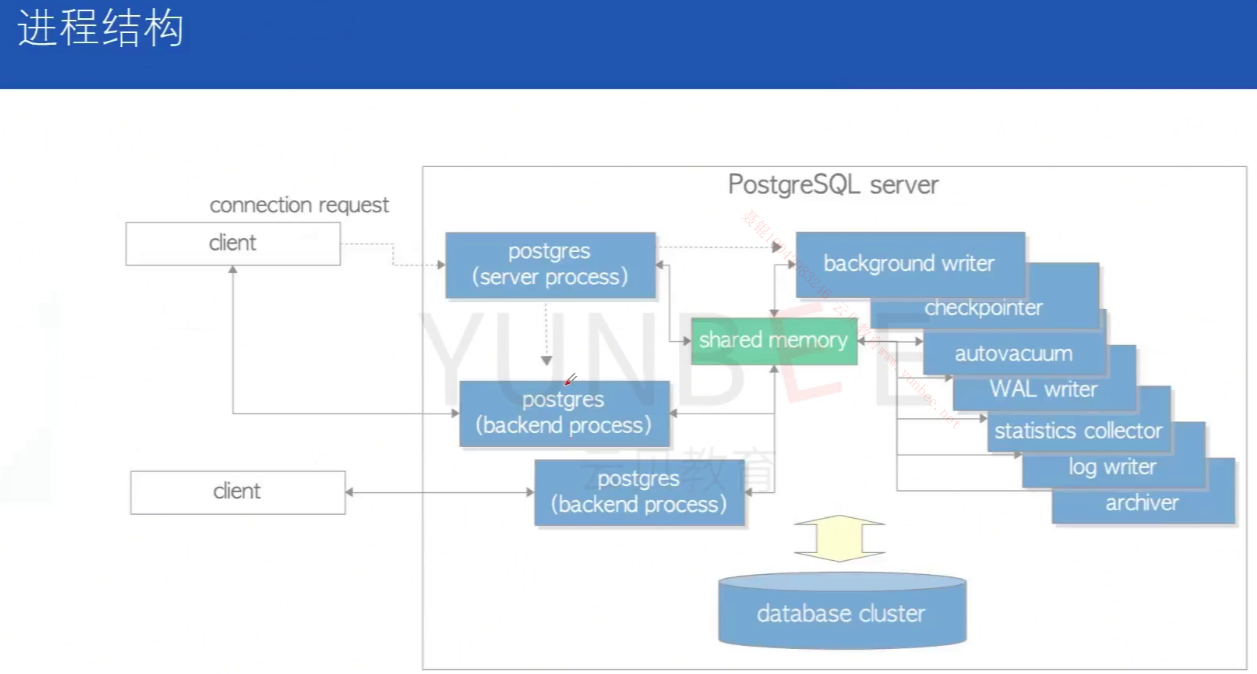
基于 PostgreSQL 实例架构图整理,覆盖:进程模型、共享内存、后台辅助进程、WAL 与 Checkpoint 协作、MVCC 与 Autovacuum 机制,并附 Oracle 对照表。
一、整体架构:一连接一进程的多进程模型
PostgreSQL 采用多进程模型(区别于 MySQL 的多线程模型),一个实例由以下部分组成:
- 1 个主进程(postmaster)
- N 个后端工作进程(每个客户端连接独占一个)
- 7 类后台辅助进程
- 一块巨大的 shared memory
- 磁盘上的 database cluster
核心特征:
- 客户端连接请求 → postmaster 认证 → fork 一个 backend 进程专门服务
- 所有进程通过 shared memory 交换数据、协调锁、传递 WAL
- 一个 backend 崩溃会导致 postmaster 重启所有 backend(fail-fast 设计)
对 Oracle 背景的人来说,这几乎就是 Dedicated Server 模式的 Oracle 实例。
二、主进程与后端进程
2.1 postgres (server process) —— postmaster 主进程
整个实例的”总管”,负责:
- 监听端口(默认 5432),接收 connection request
- 认证(md5 / scram-sha-256 / trust / peer 等)
- fork backend 进程,把认证通过的连接交给它
- 监管所有子进程的启动、监控、重启
- 处理 smart / fast / immediate 三种关停模式
- 任何子进程异常崩溃时,毁掉 shared memory 并重启所有 backend
2.2 postgres (backend process) —— 后端工作进程
每个客户端连接对应一个 backend,真正干活:
- SQL 全链路执行:parse → rewrite → planner → executor
- 直接读写 shared memory 中的 buffer
- 产生 WAL 记录写入 WAL buffer
- 客户端断开即退出,资源由 postmaster 回收
关键特性:
- 进程间无共享状态,全靠 shared memory 通信
- 单个 backend 段错误会拖垮全实例(因为共享内存可能已损坏)
三、Shared Memory 共享内存组成
| 区域 | 作用 | 类比 Oracle |
|---|---|---|
| Shared Buffers | 缓存数据页(表/索引页),默认 128MB,生产建议物理内存 25% | Buffer Cache |
| WAL Buffers | WAL 日志缓冲 | Redo Log Buffer |
| CLOG (Commit Log) | 事务提交状态(提交/中止/子事务) | Undo 段中的事务状态位 |
| Lock Manager | 轻量锁(LWLock)、重型锁(锁表) | Enqueue / Latch |
| Buffer Mapping | 哈希表,记录哪个磁盘页在哪个 buffer 槽 | X$BH |
| WAL Insert/Magic | WAL 插入点、写指针、flush 指针 | Redo 线程 |
四、七大后台辅助进程
4.1 Background Writer(后台写进程)
- 职责:周期性把 shared buffers 中的脏页批量、预防性刷到磁盘数据文件
- 目的:避免某个 backend 在需要空闲 buffer 时被迫自己刷脏页(拖慢单次 SQL)
- 触发:
bgwriter_delay=200ms,按脏页/分配槽位阈值写 - 类比 Oracle:DBWn,定位是”日常保洁”
4.2 Checkpointer(检查点进程)
- 职责:触发一次 checkpoint,把当时所有脏页刷盘,推进 redo 点
- 做什么:
- 把 shared buffers 中所有脏页写数据文件
- 把 WAL flush 到最新
- 更新控制文件(checkpoint REDO pointer)
- 记录 checkpoint 位置到 WAL
- 触发:
- 时间触发:
checkpoint_timeout=5min - 日志量触发:
max_wal_size=1GB - 手动
CHECKPOINT;
- 时间触发:
- 意义:崩溃恢复从最近 checkpoint 开始重放 WAL,checkpoint 越频繁恢复越快,但 IO 压力越大
- 类比 Oracle:CKPT + 一次 DBWn 全量刷脏
4.3 WAL Writer(WAL 日志写进程)
- 职责:把 WAL buffer 中的 WAL 记录刷到
pg_wal/下的 WAL 段文件 - 触发:
wal_writer_delay=200ms周期性写- 事务 commit 且
synchronous_commit=on时强制立刻刷盘(group commit)
- 类比 Oracle:LGWR
4.4 Autovacuum(自动清理进程)
- 职责:
- 清理 dead tuple(MVCC 下 UPDATE/DELETE 残留的旧版本行)
- 回收空闲空间、防止表膨胀(bloat)
- 自动跑 ANALYZE 更新统计信息
- 防止事务 ID 回卷(anti-wraparound)
- 组成:
autovacuum launcher(全局调度)+ 多个autovacuum worker(按表干活) - 必要性:PG 的 MVCC 不立刻删旧版本,不 vacuum 会导致表膨胀、事务 ID 耗尽数据库强制 shutdown
- 类比 Oracle:无直接对应物,是 PMON 清理 + 统计信息收集的混合体
4.5 Statistics Collector(统计信息收集进程)
- 职责:收集表/索引行数、IO 次数、活元组数、vacuum 次数等统计
- 用途:
- 给查询规划器做成本估算(执行计划准不准的根基)
- 提供
pg_stat_activity、pg_stat_database、pg_stat_user_tables等视图
- 特点:通过消息传递收集,非实时;PG15 起部分统计迁移到 shared memory
4.6 Log Writer(日志写进程)
- 职责:把日志缓冲区写到
pg_log/日志文件 - PG10 引入,替代原来每个 backend 自己写日志的方式,避免大量 backend 并发打日志造成 IO 竞争
4.7 Archiver(归档进程)
- 前提:
archive_mode=on - 职责:把已写完、不再需要的 WAL 段文件按
archive_command拷贝到归档目录 - 用途:PITR 时间点恢复、流复制/物理备份的基础
- 类比 Oracle:ARCn
五、WAL 与 Checkpoint 协作机制(深入)
5.1 WAL 是什么
- 存储位置:
$PGDATA/pg_wal/,默认每个段文件 16MB(PG11 起可在 initdb 时用--wal-segsize调整) - 每条 WAL 记录有全局唯一的 LSN(Log Sequence Number),8 字节,是整个实例的字节偏移量,单调递增
- WAL 记的不是 SQL,而是物理级别的”对哪个 page 的哪个 offset 做了什么修改”,类似 Oracle 的 change vector
- 例:一条 INSERT 记录的是”在 rel 1663/12345 的 block 0x2a 偏移 0x40 处插入 tuple (xmin=100, …)”
- 为什么记物理不记逻辑:崩溃恢复时数据页可能本身就是半截写坏的,物理重放能幂等地把页拉回一致状态
5.2 LSN 坐标体系
WAL 写入流:
┌──────────────────────────────────────────────────┐
│  已可回收  |  redo点  |  已产生WAL  | 已flush   │
│  (归档/复用) ↑         ↑            ↑            │
│           redo_ptr   write_ptr    flush_ptr     │
└──────────────────────────────────────────────────┘
                          ↑
崩溃恢复从 redo_ptr 开始重放redo_ptr:最近一次 checkpoint 的起点write_ptr:WAL 已写入 buffer 的位置flush_ptr:WAL 已真正 fsync 到磁盘的位置- 流复制、复制 slot、
pg_stat_replication看到的全是这几个指针的差值
5.3 事务提交时的刷盘逻辑(Group Commit)
- backend 产生 WAL 记录 → 写入 WAL buffer(内存)
synchronous_commit=on(默认)时,commit 必须等 WAL 真的 fsync 到磁盘- 多个事务在
wal_writer_delay=200ms窗口内一起提交 → WAL writer 一次 fsync 刷多条,即 group commit
实战推论:”提交慢”绝大多数情况是 WAL 刷盘慢,不是数据页写慢。把
pg_wal单独放到一块 SSD,是 PG 性价比最高的优化之一。
5.4 Checkpoint 分阶段动作
一次 checkpoint 不是瞬间动作,而是:
- 写一条 checkpoint record 到 WAL(记录当前 redo 起点 = redo_ptr)
- 扫描 shared buffers 中所有脏页
- 把脏页刷到数据文件——PG 8.4 之后不是 checkpointer 一个人刷,而是让 backend 和 bgwriter 一起参与分摊 IO
- 更新控制文件,记录最新 checkpoint 位置
- 回收旧 WAL:比 redo_ptr 更早的 WAL 段就可以归档/复用
5.5 Checkpoint 卡顿与调优
- 脏页太多时集中刷盘 → IO 尖峰 → 业务抖动
- 关键参数:
checkpoint_completion_target=0.9(默认 0.5):把刷脏动作均匀摊到整个 checkpoint 间隔,而不是最后一刻猛刷max_wal_size:太小 → checkpoint 太频繁;太大 → 崩溃恢复慢、磁盘占用大checkpoint_timeout=5min:时间触发
- 经验值:OLTP 场景
max_wal_size调到 4GB–16GB,completion_target=0.9
六、MVCC 与 Autovacuum 机制(深入)
6.1 每行数据自带两个隐藏字段
每个 tuple 都有:
- xmin:插入这行的事务 ID
- xmax:删除/更新这行的事务 ID(未删除则为 0)
一个事务读一行时,根据自己的 snapshot 判断这行对它可不可见。
6.2 UPDATE 不是原地改,是”插新版本 + 标旧版本”
这是 PG 和 Oracle 最根本的架构分歧:
Oracle:UPDATE 一行
  └─ 在原 block 上原地改
     └─ 旧版本扔到 undo 段
     └─ 读一致性:current block + undo 拼接

PostgreSQL:UPDATE 一行
  └─ INSERT 一个新 tuple(xmin = 当前事务)
  └─ 旧 tuple 的 xmax 被设为当前事务
  └─ 旧 tuple 留在原 data block 里,变成 dead tuple
6.3 Dead Tuple 与 Vacuum
- 旧版本 tuple 不会立刻删,因为可能还有长事务需要它
- 当所有能看到它的事务都结束后,它就变成 dead tuple——占着空间但没人用
- 普通 VACUUM 做什么:
- 扫描每个 page,把 dead tuple 标记为可重用(记到 FSM 空闲空间映射)
- 更新 visibility map
- 不把空间还给 OS
- VACUUM FULL:真正重写表、归还 OS,但会锁表,生产慎用
- 不 vacuum 的后果:表膨胀(bloat)、索引膨胀、全表扫描越来越慢、buffer 缓存命中率下降
6.4 XID 防回卷(Wraparound)—— PG 的”生死线”
- 事务 ID 是 32 位无符号整数,最大约 20 亿
- 当一个老事务 XID 比新事务老 20 亿以上时,会发生 XID wraparound(回卷)——老事务在数值上”比新事务还新”,可见性判断直接错乱
- PG 的对策叫 freeze:把足够老的 tuple 的 xmin 改成特殊值
FrozenXID,让它对所有事务都可见,不再参与 XID 比较 - autovacuum 会在以下情况强制启动(即使
autovacuum=off):- 表的”年龄”超过
autovacuum_freeze_max_age(默认 2 亿) - 整个库最老 XID 距离回卷只剩 100 万事务时
- 表的”年龄”超过
- 如果不及时 freeze,PG 会主动 safe shutdown,拒绝任何连接,逼你手动 vacuum
这是 PG DBA 最不能掉以轻心的事——比慢查询严重得多。
6.5 Autovacuum 内部调度
- autovacuum launcher:全局调度,每
autovacuum_naptime(默认 1min)扫一遍哪些表需要 vacuum - autovacuum worker:真正干活的进程,最多
autovacuum_max_workers(默认 3)个 - 触发某张表 vacuum 的条件:
dead_tuple 数量 > autovacuum_vacuum_threshold(默认50) + autovacuum_vacuum_scale_factor(默认0.2) × 表行数 - 100 万行的表要攒到 20 万 dead tuple 才触发一次 autovacuum——大表往往等太久,生产环境常把这两个参数调小
七、关键流程串联
7.1 一次 UPDATE 从 SQL 到落盘
client
  │ SQL
  ▼
backend process ──修改 shared buffer 中的数据页(产生脏页)
       │
       ├──产生 WAL 记录 → WAL buffer
       │                    │
       │  commit 时          ▼
       │            WAL writer 把 WAL 刷盘(fsync)
       │                    │
       │            返回"提交成功"给客户端(synchronous_commit=on)
       ▼
脏页留在 shared buffer,稍后由:
   ├── background writer 周期性刷脏(日常)
   └── checkpointer 周期性全量刷脏(大扫除)
核心原则:WAL 先于数据页落盘(Write-Ahead Logging)。即使数据页还没刷盘就崩溃,重启时也能从 checkpoint 位置重放 WAL 把数据找回来。
7.2 数据库崩溃重启流程
- postmaster 启动,读控制文件发现上次非正常关闭
- 从最近一次 checkpoint 的 REDO 点开始重放 WAL
- 把所有已提交但未刷盘的数据页重放出来
- 未提交事务回滚
- 接受新连接
max_wal_size 决定了两次 checkpoint 之间的距离,也就决定了崩溃恢复时长。
八、PostgreSQL 与 Oracle 对照表
| PostgreSQL | Oracle | 说明 |
|---|---|---|
| postmaster (server process) | PMON + listener | 主进程 |
| backend process | dedicated server process | 一连接一进程 |
| shared memory | SGA | 实例内存 |
| shared buffers | buffer cache | 数据页缓存 |
| WAL buffers / WAL writer | redo log buffer / LGWR | 预写日志 |
| background writer | DBWn | 脏页刷盘 |
| checkpointer | CKPT | 检查点 |
| autovacuum | (无直接对应) | MVCC 死元组清理 |
| statistics collector | AWR/ASH 收集 | 统计信息 |
| archiver | ARCn | 日志归档 |
| WAL | redo log | 重做日志 |
| dead tuple + vacuum | undo + block cleanout | 旧版本清理 |
| 多进程模型 | 多进程 + 线程池 | PG 每个连接一个 OS 进程 |
MVCC 架构哲学差异
| 维度 | Oracle | PostgreSQL |
|---|---|---|
| UPDATE 行为 | 原地修改 block | 插入新版本,旧版本变 dead tuple |
| 旧版本存放 | undo 表空间 | 就在主数据 block 里 |
| 读一致性 | current block + undo 拼接 | tuple 自带 xmin/xmax,按 snapshot 判断 |
| 旧版本回收 | PMON/SMON 自动回收 undo | 必须靠 autovacuum 清理 dead tuple |
| 事务 ID | SCN,48 位,不用担心回卷 | XID,32 位,必须 freeze 防回卷 |
| 统计信息 | 自动收集任务 / DBMS_STATS | autovacuum 顺带做 ANALYZE |
| 表膨胀风险 | 低(undo 分离) | 高(bloat 是日常头号问题) |
九、实战要点与常见问题
- 为什么用进程不用线程:稳定(一个进程崩了不至于整个实例崩)+ 锁模型简单;代价是上下文切换贵,连接数上千就吃不住——这就是 PgBouncer 连接池在 PG 生态几乎必装的原因。
- bgwriter 和 checkpointer 为什么要分两个进程:bgwriter 是”少量多次”维持 buffer 池干净,checkpointer 是”周期性大动作”推进恢复点,分工不同,不能合并。
- autovacuum 是 PG DBA 头号日常:表膨胀、XID 回卷、统计信息滞后,几乎都和它有关;
autovacuum_vacuum_scale_factor、autovacuum_naptime、maintenance_work_mem是最常调的三个参数。 - 单 backend 崩溃会拖垮全实例:和 MySQL 一个连接崩了不影响其他连接不同,PG 是 fail-fast,宁可全部重启也不带着可能损坏的 shared memory 跑。
- WAL 放 SSD 是性价比最高的优化:提交延迟的瓶颈通常在 WAL fsync,不在数据页写盘。
max_wal_size与崩溃恢复时间的权衡:太小 → 频繁 checkpoint、IO 抖动;太大 → 崩溃恢复慢、磁盘占用大。OLTP 经验值 4GB–16GB。
十、一句话总结
- WAL + Checkpoint:解决”崩溃了怎么恢复”,靠的是先日志后数据 + 周期性推进 redo 点;WAL 放 SSD、调大
max_wal_size+completion_target=0.9,是稳定性和性能的关键。 - MVCC + Autovacuum:解决”并发读写不锁”的代价,靠的是版本链 + 后台清理;代价是必须盯着表膨胀和 XID 回卷——这是 PG DBA 区别于其他 DBA 的核心日常。