 徐万新之路
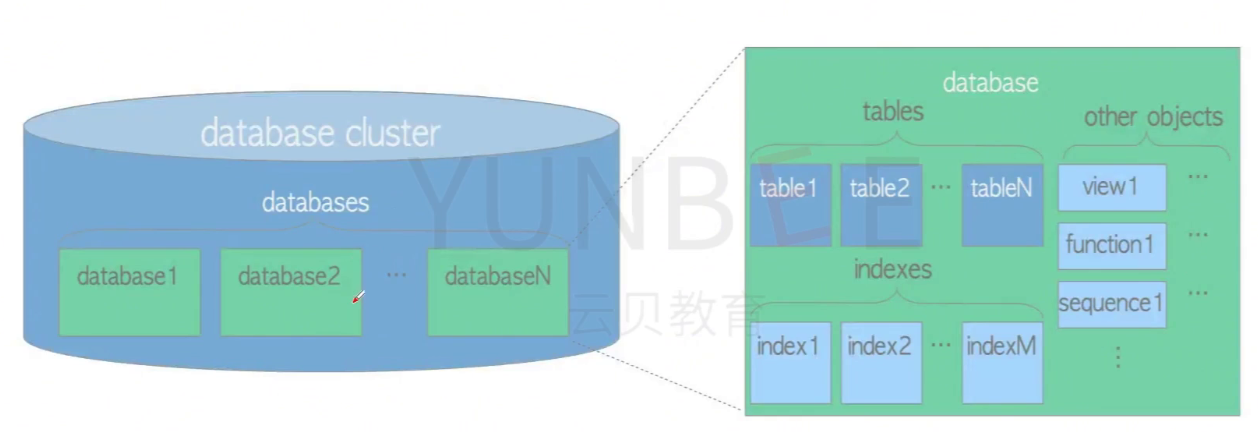
0. 参考图(用户提供)
database cluster
└── databases: database1 / database2 / … / databaseN
    └── database 内部
        ├── tables: table1 / table2 / … / tableN
        ├── indexes: index1 / index2 / … / indexM
        └── other objects: view1 / function1 / sequence1 / …
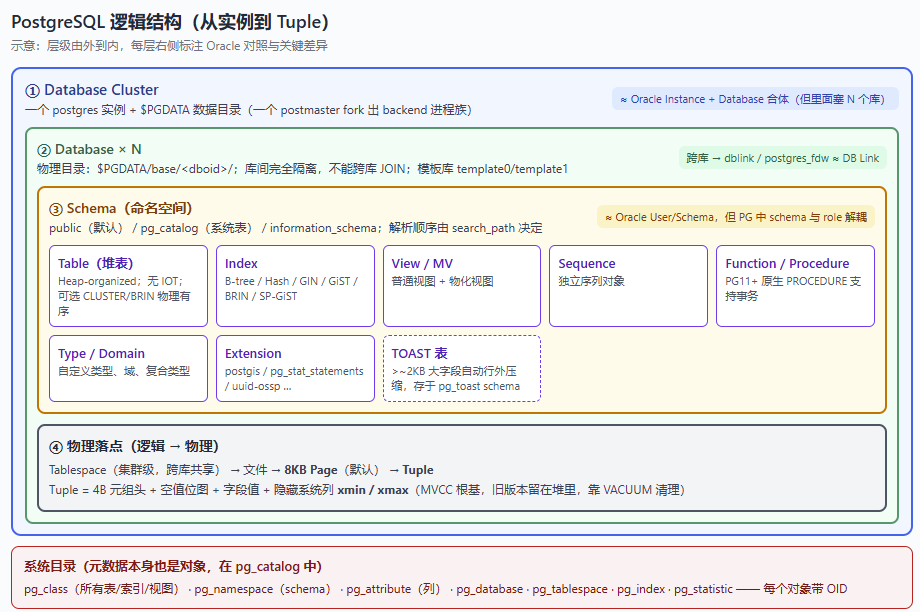
1. 五层结构总览
Database Cluster(一个 postgres 实例 + $PGDATA 数据目录)
└── Database(N 个,互相隔离的物理目录)
    └── Schema(命名空间:public / pg_catalog / information_schema / 自定义)
        └── Object(Table / Index / View / Sequence / Function / Type / Extension …)
            └── 物理落点:Tablespace → 文件 → 8KB Page → Tuple
2. 逐层详解
2.1 Database Cluster(数据库集群)
- 一个 PG Cluster = 一个 postgres 实例 + 一个数据目录($PGDATA)。
- 启动后由一个 postmaster 进程 fork 出若干 backend 进程与辅助进程(checkpointer、writer、walwriter、autovacuum launcher、logical replication launcher …)。
- 内部可挂 N 个独立 database。
- 注意:PG 的 “cluster” 不是 Oracle RAC 那种多实例共享存储;它只是”单实例管多个库”的逻辑集合。多机高可用走流复制 / 逻辑复制 / Citus 等方案。
Oracle 对照:≈ Instance + Database 的合体,但里面塞了 N 个互不相干的库。
2.2 Database(数据库)
- 物理上是
$PGDATA/base/<dboid>/下的一个子目录。 - 库与库之间完全隔离:
- 不能跨库
JOIN; - 不能跨库引用 schema / 表 / 视图;
- 跨库只能走
dblink、postgres_fdw,或逻辑复制把数据搬过来。
- 不能跨库
- 自带两个模板库:
template0:干净的模板;template1:建库时默认克隆,你装在 template1 里的扩展会被新库继承。
Oracle 对照:Oracle 一个 Database 里用 schema/user 隔对象;PG 把”隔对象”往上抬了一层——先隔库,库内再用 schema 隔。
2.3 Schema(模式)
- database 内的命名空间,用于把同类对象分组,避免同名冲突。
- 默认 schema:
public:建库后给用户用的默认 schema(PG15 起收回了 PUBLIC 的 CREATE 权限);pg_catalog:系统表所在的 schema(自动在 search_path 最前面);information_schema:SQL 标准视图层。
- 对象解析顺序由
search_path决定,典型值:"$user", public。
Oracle 对照:≈ User/Schema,但 PG 里 schema 和 role 是解耦的——一个 role 可以用任意 schema,不像 Oracle user=schema 绑定。
2.4 Schema 内的对象
| 对象 | 说明 | Oracle 对应 |
|---|---|---|
| Table | 默认是堆表(heap-organized),无索引组织表;可用 CLUSTER 或 BRIN 做物理有序 | Heap Table / IOT |
| Index | 类型丰富:B-tree(默认)、Hash、GIN、GiST、BRIN、SP-GiST | Index(类型少) |
| View / Materialized View | 普通视图 + 物化视图 | View / Materialized View |
| Sequence | 序列对象 | Sequence |
| Function / Procedure | PG11+ 原生支持 PROCEDURE(带事务) | Function / Procedure |
| Trigger / Rule | 行级 / 语句级触发器 | Trigger |
| Type / Domain / Composite Type | 自定义类型、域、复合类型 | Object Type / VARRAY |
| Extension | 一键打包安装的扩展(postgis、pg_stat_statements、uuid-ossp …) | 类似外部组件 / 包 |
| TOAST 表 | 大字段(>~2KB)自动拆到 pg_toast schema 下行外压缩存储 | LOB 段 |
2.5 系统目录(元数据本身也是对象)
元数据存在 pg_catalog schema 中,DBA 最常用的几张:
| 系统表 | 作用 |
|---|---|
pg_class | 所有表 / 索引 / 视图 / 序列的元数据(relkind 区分类型) |
pg_namespace | schema 字典 |
pg_attribute | 列字典 |
pg_database | 数据库字典 |
pg_tablespace | 表空间字典 |
pg_index | 索引元数据 |
pg_statistic | 统计信息(优化器用) |
每个对象有一个 OID,是它在系统里的身份证。
3. 逻辑 → 物理的桥
- Tablespace(表空间):集群级对象,一个表空间可以被多个 database 共用(和 Oracle 表空间属于单个 database 不一样)。
- 一个表 = 堆表 +(可选)TOAST 表 + 索引表,各自在
pg_class里是一行。 - 行(Tuple)物理结构:
4 字节元组头 + 空值位图 + 字段值 + 隐藏系统列 xmin / xmax - 默认页大小 8KB(编译时可改),对应 Oracle 的 Block。
4. 深入一:MVCC 与 VACUUM
4.1 为什么需要 MVCC
- 读写不互相阻塞:读的人看到一致性快照,写的人只锁自己要改的行。
- 实现方式:不在原地改数据,而是保留多版本。
4.2 两个隐藏系统列
xmin:插入这一行(版本)的事务 ID。xmax:删除 / 更新这一行(版本)的事务 ID;未删除时为无效值。
4.3 UPDATE 的真实动作
PG 的 UPDATE 不是原地更新:
- 把旧 tuple 标记为 dead:
xmax = 当前事务 ID; - 插入一条新 tuple:
xmin = 当前事务 ID; - 旧版本仍留在堆表里,只是对不兼容快照的事务不可见。
→ 这就是 PG 表膨胀(bloat)的根因。
4.4 快照(Snapshot)如何决定可见性
一个事务启动时拿到一个快照,里面记录了:
- 当时活跃的事务 ID 列表;
- 上一个完成的事务 ID(xmax)。
可见性规则(简化):
xmin已提交,且xmin在快照启动前已结束 → 这行版本是”插入”状态;xmax为空,或xmax还没提交,或xmax在快照启动时还在运行 → 这行版本对当前事务仍可见;- 否则不可见。
4.5 VACUUM 在干什么
| 命令 | 作用 | 锁 | 是否收缩文件 |
|---|---|---|---|
VACUUM | 扫描表,把 dead tuple 标记为可复用 | 不阻塞 DML | 否(只标记) |
VACUUM FULL | 整表重写,物理收缩 | AccessExclusiveLock | 是(生产慎用) |
VACUUM ANALYZE | 清理 + 重新收集统计信息 | 不阻塞 DML | 否 |
autovacuum | 后台自动调度,基于阈值自动跑 | 不阻塞 DML | 否 |
4.6 事务 ID 回卷(Wraparound)
- 老 PG 用 32 位 xid,循环使用;
- 当一个 tuple 太老、
xmin被”绕回去”时,会发生事务 ID 回卷,数据库强制停机; - Freezing 机制:VACUUM 会把足够老的 tuple 标记为 frozen(xmin = 2),不再受 xid 影响;
- PG13+ 引入 64 号 epoch 缓解问题,但 freezing 仍是日常运维主线。
4.7 与 Oracle 的关键差异
| 维度 | PostgreSQL | Oracle |
|---|---|---|
| 旧版本存哪 | 留在堆表里(dead tuple) | Undo Tablespace |
| 写是否阻塞读 | 不阻塞(MVCC) | 不阻塞(一致性读) |
| 读是否阻塞写 | 不阻塞 | 不阻塞 |
| 回收方式 | VACUUM / autovacuum | Undo 自动回收 |
| 膨胀来源 | dead tuple 堆积 | 行迁移 / 链 |
5. 深入二:TOAST(大字段存储)
5.1 触发条件
- PG 默认页大小 8KB,一个 tuple 不能跨页(必须放得进一个页);
- 当一行所有字段加起来超过
TOAST_TUPLE_THRESHOLD(默认 2KB),触发 TOAST。
5.2 四种存储策略
| 策略 | 压缩 | 行外存储 | 说明 |
|---|---|---|---|
PLAIN | 否 | 否 | 不压缩不外联(适合定长、短字段) |
EXTERNAL | 否 | 是 | 外联不压缩(适合读多的大字段) |
EXTENDED | 是 | 是 | 先压缩再外联(默认) |
MAIN | 是 | 尽量不 | 先压缩,尽量留在主表 |
5.3 物理结构
- 主表行里大字段变成一个 TOAST pointer(指针);
- 真实数据被切成约 2KB 一块的 chunks,存到
pg_toast.pg_toast_<tableoid>表; - 每个 chunk 是一行,通过
chunk_id+chunk_seq排序还原。
5.4 与 Oracle LOB 对比
- Oracle:LOB 需要显式建 LOB 段、指定 SEGMENT / CACHE / NOCACHE;
- PG:透明处理,建表时不用操心,字段自动按策略 TOAST。
6. 深入三:声明式分区(PG10+)
6.1 分区方式
CREATE TABLE orders (
    id bigint,
    created_at date,
    region text,
    amount numeric
) PARTITION BY RANGE (created_at); -- RANGE / LIST / HASHRANGE:按区间(按月、按年);LIST:按枚举值(按 region);HASH:按哈希取模(打散热点)。
6.2 物理结构
- 分区表本身是逻辑容器,不存数据;
- 每个分区是一个独立的子表(继承关系),数据真实落在分区里;
- 多级分区:子分区上还可以再
PARTITION BY。
6.3 关键优化:分区裁剪(Partition Pruning)
- 优化器在生成执行计划时,根据 WHERE 条件排除不相关分区;
- 只扫描命中的分区,而不是全表;
- 例:
WHERE created_at = '2026-10-01'只扫 10 月分区。
6.4 版本演进要点
- PG10:声明式分区初版;
- PG11:支持
DEFAULT分区、在线加分区、分区表上的PRIMARY KEY(含分区键); - PG12:分区表上的外键、分区索引;
- PG13+:增量分区、更多裁剪优化。
6.5 与 Oracle 分区对比
| 维度 | PostgreSQL | Oracle |
|---|---|---|
| 分区方式 | RANGE / LIST / HASH | RANGE / LIST / HASH / RANGE-LIST … |
| 分区表是否存数据 | 否(纯逻辑容器) | 否(类似) |
| 全局索引 | 不支持原生全局索引 | 支持全局索引 |
| 分区裁剪 | 优化器自动 | 优化器自动 |
7. 与 Oracle 的关键差异 Checklist(DBA 视角)
- 实例 : 库 = 1 : N(PG)vs 1 : 1(Oracle)——多业务隔离优先用 schema 还是独立 database,要想清楚。
- schema ≠ role(PG)vs user = schema(Oracle)——权限模型要重新适应。
- 跨库查询必须走 FDW / DBLINK,不像 Oracle 一个库内就能跨 schema 随便查。
- MVCC 不用 undo 表空间,旧版本留在堆里,
VACUUM/ autovacuum 是日常运维主线。 - 没有 extent / 段级管理,表膨胀靠统计信息 + vacuum 治理,不是靠 allocate / deallocate 区间。
- TOAST 透明处理大字段,不用像 Oracle 那样显式建 LOB 段。
- 表空间是集群级,可跨库共用;Oracle 表空间属于单个 database。
- 事务 ID 回卷风险,必须监控 freezing 进度,不能放任 autovacuum 躺平。
- 无 IOT,物理有序只能靠
CLUSTER(一次性重写)或 BRIN 索引。 - 跨库 JOIN 性能差(走 FDW),大表关联尽量在同一 database 内完成。
8. 常用系统目录速查 SQL
-- 查看当前 database 下所有 schema
SELECT schema_name FROM information_schema.schemata;

-- 查看某张表的 OID、类型、表空间
SELECT relname, relkind, reltablespace, reltuples
FROM pg_class
WHERE relname = 'orders';

-- 查看表的列
SELECT attname, format_type(atttypid, atttypmod) AS type
FROM pg_attribute
WHERE attrelid = 'orders'::regclass AND attnum > 0;

-- 查看当前 search_path
SHOW search_path;

-- 查看表是否膨胀(粗略)
SELECT relname, n_live_tup, n_dead_tup,
       round(n_dead_tup::numeric / NULLIF(n_live_tup, 0) * 100, 2) AS dead_pct
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC;

-- 查看 autovacuum 配置
SHOW autovacuum;
SHOW autovacuum_vacuum_threshold;
SHOW autovacuum_analyze_threshold;
9. 一页纸总结
Cluster 管 N 个 Database,Database 内用 Schema 隔对象,Schema 内放 Table/Index/View/Function/Extension 等;数据最终落在 8KB Page 里,每行带 xmin/xmax 两个隐藏系统列支撑 MVCC,旧版本靠 VACUUM 回收;大字段自动 TOAST 行外压缩;大表用声明式分区做裁剪。和 Oracle 最大的认知差:PG 是”一实例多库、库间隔离、schema 与 role 解耦、MVCC 留在堆里”。