 徐万新之路
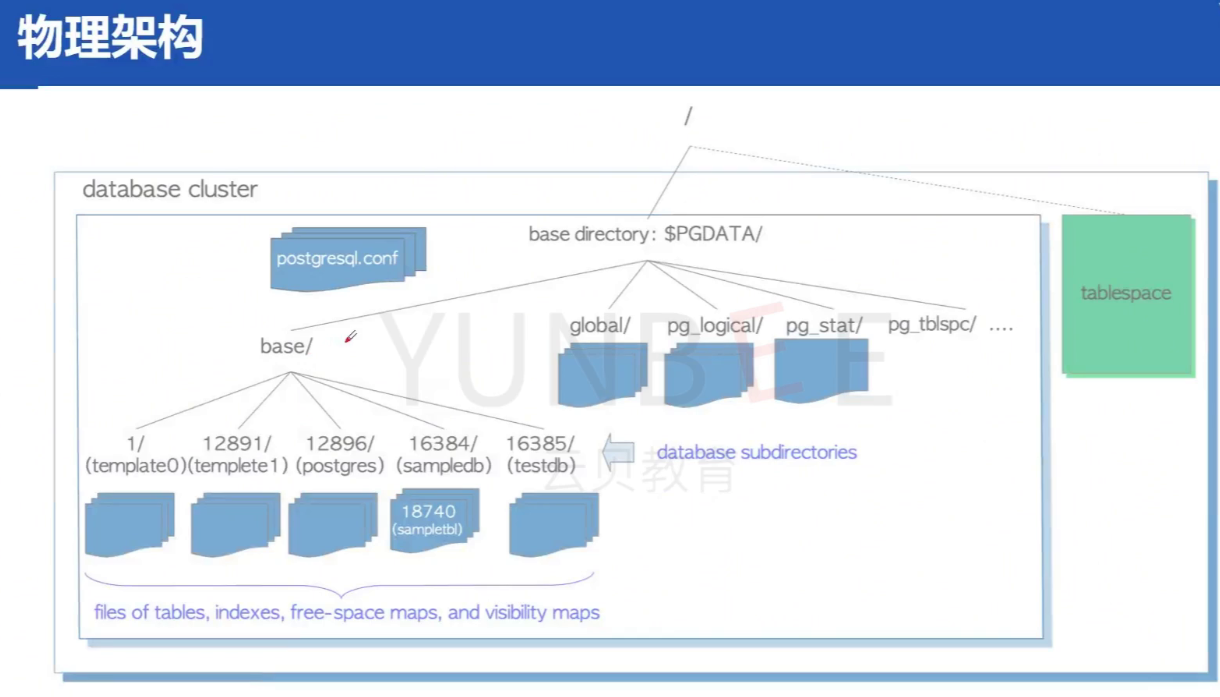
对应课程图:
database cluster→$PGDATA/基目录 →base/ global/ pg_logical/ pg_stat/ pg_tblspc/→ 数据库子目录 → 表/索引/FSM/VM 数据文件。
本文按”实例聚簇(cluster)→ 数据目录 → 数据库 → 表/索引 → 物理文件“自顶向下展开。
0. 一张图看懂整体分层
PostgreSQL Cluster(数据库聚簇,一个 instance 管理一个 PGDATA)
│
└── $PGDATA/                        ← 基目录(数据区根,initdb 初始化)
    ├── postgresql.conf / pg_hba.conf / pg_ident.conf   ← 配置文件
    ├── global/                     ← 聚簇级共享系统目录(pg_database 等)
    ├── base/                       ← 每个数据库一个子目录(OID 命名)
    │   ├── 1/          (template0)
    │   ├── 12891/      (template1)
    │   ├── 12896/      (postgres)
    │   ├── 16384/      (sampledb)
    │   └── 16385/      (testdb)
    │       └── 18740            ← 表 relfilenode(sampletbl 的数据文件)
    │           ├── 18740        主数据文件(堆表)
    │           ├── 18740_fsm    Free Space Map(空闲空间映射)
    │           ├── 18740_vm     Visibility Map(可见性映射)
    │           └── 18740_init   (仅 unlogged 表的 init fork)
    ├── pg_wal/                     ← 预写日志(旧版 pg_xlog)
    ├── pg_logical/                 ← 逻辑解码/复制槽状态
    ├── pg_stat/  pg_stat_tmp/      ← 统计信息持久化
    ├── pg_tblspc/                  ← 表空间符号链接(指向自定义存储路径)
    ├── pg_commit_ts/ pg_notify/ pg_serial/ pg_snapshots/ pg_subtrans/ pg_multixact/
    └── postmaster.pid / postmaster.opts
核心概念:
- Cluster(聚簇)≠ MySQL 实例里多个 database 的松散集合:PG 的一个实例(postmaster/backend 进程树)只对应一个
$PGDATA,里面”装”着多个 database。 - Database 之间物理隔离:每个 database 数据落在
base/<dbOID>/(或表空间下),不能跨库直接SELECT * FROM db2.tbl,这是与 Oracle”一个实例多表空间”、MySQL”一个实例多库可互相访问”的关键区别。 - OID / relfilenode:系统用 OID 标识对象,真正落盘的文件名是
relfilenode(不一定等于 OID,VACUUM FULL/REINDEX会改写)。
1. $PGDATA 基目录(数据区根)
由 initdb -D /path/to/pgdata 初始化,postgresql.conf 里 data_directory 指向它。主要内容:
| 条目 | 作用 |
|---|---|
postgresql.conf | 主配置(端口、内存、WAL、并行、日志等);也可放配置目录 conf.d/ 或外部路径 |
pg_hba.conf | 客户端认证规则(host/local、md5/scram、IP 白名单) |
pg_ident.conf | 操作系统用户 → 数据库用户映射 |
postmaster.opts | 记录上次启动命令行 |
postmaster.pid | 单实例锁文件 + PID,防止重复启动 |
global/ | 聚簇共享系统表(见 §2) |
base/ | 各数据库本体(见 §3) |
pg_wal/ | 预写日志 WAL(见 §6) |
pg_tblspc/ | 表空间软链(见 §5) |
pg_logical/ | 逻辑复制槽、解码快照 |
pg_stat/ | 持久化的统计计数器(pg_stat_* 视图来源) |
pg_commit_ts/ | 事务提交时间戳(开启 track_commit_timestamp) |
pg_notify/ | LISTEN/NOTIFY 队列文件 |
pg_serial/ | 可序列化隔离事务信息 |
pg_subtrans/ | 子事务(subtransaction)状态 |
pg_multixact/ | 多事务(多行被并发锁)状态 |
pg_snapshots/ | 导出的快照(pg_export_snapshot) |
log/ | 服务器日志(logging collector 输出,log_directory 控制) |
⚠️ 物理备份/复制的最小集合:
$PGDATA全量 + 持续归档的 WAL(pg_wal或 archive)。直接拷贝数据文件做一致性备份必须配合pg_start_backup()/pg_stop_backup()或用pg_basebackup,否则会裂。
2. global/ 聚簇级共享系统目录
存放整个聚簇只有一份的系统 catalog,不隶属于任何单个 database:
pg_database:聚簇里所有数据库的清单(OID、encoding、归并序、owner)——所以你连上任意库都能SELECT datname FROM pg_database。pg_tablespace、pg_control(控制文件二进制,记录系统检查点、RECV 起点、TLI 时间线)、pg_filenode.map、pg_internal.init等。pg_control内容用pg_controldata $PGDATA查看(系统状态、checkpoint WAL 位置、 WAL 段大小、页大小)。
对应课程图里
global/那一摞文件:它是”聚簇元数据中枢”。
3. base/ —— 每个数据库一个 OID 子目录
base/ 下每个子目录名就是数据库的 OID(oid 列,见 SELECT oid, datname FROM pg_database;):
| 目录名 | 对应库 | 说明 |
|---|---|---|
1/ | template0 | 模板库(不可连接,作为建库模板) |
12891/ | template1 | 默认建库模板(CREATE DATABASE 不带 TEMPLATE 时用它) |
12896/ | postgres | 默认维护库 |
16384/ | sampledb | 用户自建库(OID 通常 ≥ 16384) |
16385/ | testdb | 用户自建库 |
进入某个库目录后,看到的是该库所有对象的物理文件,文件名 = relfilenode:
- 表的数据文件、索引文件、TOAST 表、序列、系统 catalog 全在这里;
- 名字是一串数字,不直接叫表名,要反查:
-- 查表 sampletbl 的 relfilenode SELECT relname, relfilenode, reltablespace FROM pg_class WHERE relname = 'sampletbl';课程图里18740 (sampletbl)就是这个 relfilenode。
4. 表/索引的物理文件:主文件 + FSM + VM + init fork
一张表(堆表)在磁盘上通常对应同一个 relfilenode 的多个 fork(分叉文件):
| 文件名 | fork | 作用 |
|---|---|---|
18740 | main | 堆数据文件本体,按 8KB 页(page)组织 |
18740_fsm | fsm | Free Space Map:记录每个页还有多少空闲空间,插入/UPDATE 找可用页时用 |
18740_vm | vm | Visibility Map:哪些页对所有事务可见(全可见位),加速 index-only scan、VACUUM 跳过全可见页 |
18740_init | init | 仅 unlogged 表:崩溃重建时用它初始化 |
关键点:
- 页大小默认 8KB(
BLCKSZ,编译时定,见pg_controldata)。 - 单文件超过 1GB(默认)自动切段:
18740、18740.1、18740.2……这是历史上应对 2GB/32 位文件限制的设计,段号从 1 开始。 - 索引文件:每个索引也有自己的 relfilenode(同样的数字名),B-tree 索引内部也是页结构;
REINDEX会生成新 relfilenode 再切换。 - TOAST 机制:行宽超过约 2KB(
TOAST_TUPLE_THRESHOLD)时,大字段被压缩/外存到独立的 TOAST 表(pg_toast_<表OID>),主表只存指针。 - FSM 不会被 VACUUM 自动收缩成 0:它是密度映射,空闲信息靠
VACUUM回收后更新。 - VM 与 Hint Bits:第一次全表扫描时会给 VM 打”全可见”标记,这就是为什么大表冷启动第一次扫描会产生 xlog/脏页。
5. 表空间(Tablespace)与 pg_tblspc/
课程图右侧那块绿色 tablespace,物理上就是:
CREATE TABLESPACE ts LOCATION '/data/pg_ts';- 在
$PGDATA/pg_tblspc/下生成一个以表空间 OID 命名的符号链接(Windows 上是 junction/copy),指向/data/pg_ts; - 表空间目录里再按
PG_VERSION/版本/数据库OID/组织对象文件。
要点:
- 表空间只是”换个目录放文件”,不改变 cluster 只有一个 PGDATA 的事实,
pg_tblspc是入口。 CREATE TABLE ... TABLESPACE ts;时,该表的 relfilenode 文件落在表空间路径下,pg_class.reltablespace记录它。- 表空间级别可以
CREATE DATABASE ... TABLESPACE让整库落到自定义盘。 - 备份/克隆时不能只拷 PGDATA,表空间是软链,要连同实际目录一起恢复,否则起不来。
6. pg_wal/ —— 预写日志(Write-Ahead Logging)
- 旧称
pg_xlog(9.6 之前叫 xlog,10 起改名pg_wal)。 - 每个 WAL 段默认 16MB(
--wal-segsize编译/initdb 时定),文件名是 24 位十六进制:00000001000000000000000A。 - 作用:先日志后数据页,保证崩溃可恢复(ARIES 风格)、支持流复制、PITR 时间点恢复。
- 相关参数:
wal_level(replica/logical)、max_wal_size、min_wal_size、checkpoint_timeout、archive_mode+archive_command(归档)。 - 物理架构上它和数据页分离目录,可以把
pg_wal单独挂高速盘,降低写竞争。
7. 后台进程与内存(物理运行时视图)
物理存储之外,”一个实例在跑”时还包括进程和共享内存:
主要后台进程:
postmaster:守门进程,监听端口、fork/回收 backend。checkpointer:执行 checkpoint,把脏页刷盘并推进 REDO 起点。bgwriter:主动批量刷脏页,降低 checkpoint 突发 IO。walwriter:把 WAL 缓冲区写 pg_wal。walsender/walreceiver:主从流复制发送/接收。autovacuum launcher / worker:自动 dead tuple 清理与表统计更新。logical replication launcher、stats collector(新版改为pg_stat进程)等。
共享内存(Shared Memory):
shared_buffers:堆表页缓存(默认 128MB,生产建议物理内存 25% 左右)。- WAL 缓冲区、commit log(clog,提交状态)、lock manager、disk quorum 等。
8. 常用排查命令(对照物理架构)
# 1. 看数据目录结构与控制信息
pg_controldata $PGDATA
ls -l $PGDATA

# 2. 找某个库的 OID → 对应 base 目录
psql -c "SELECT oid, datname FROM pg_database;"

# 3. 找某张表的物理文件
psql -c "SELECT relname, relfilenode FROM pg_class WHERE relname='sampletbl';"
# 然后去 base/<dbOID>/ 或对应表空间目录下找 relfilenode 文件

# 4. 看表空间实际路径
psql -c "\db+"
ls -l $PGDATA/pg_tblspc/

# 5. 看表大小(含 FSM/VM/TOAST)
psql -c "\dt+ sampletbl"
psql -c "SELECT pg_size_pretty(pg_total_relation_size('sampletbl'));"

# 6. WAL 状态
psql -c "SELECT * FROM pg_wal_lsn_diff(pg_current_wal_lsn(), '0/0');"
ls -lh $PGDATA/pg_wal/
9. 与 Oracle / MySQL 的对照(帮助记忆)
| 维度 | PostgreSQL | Oracle | MySQL(InnoDB) |
|---|---|---|---|
| 实例与库 | 一个实例一个 PGDATA,多库物理隔离 | 一个实例多表空间,库=schema | 一个实例多库,库间可访问 |
| 数据根 | $PGDATA/base/<dbOID>/ | 各表空间 .dbf | datadir/<db名>/ |
| 表文件 | relfilenode 数字文件 + FSM/VM | 段/区/块,统一在表空间 | 每库每表 .ibd |
| 预写日志 | pg_wal(WAL) | redo log | ib_logfile |
| 回滚 | undo(元组版本+vacuum,无独立 undo 表) | undo 表空间 | undo log |
| 复制 | 流复制(WAL 字节) | Data Guard / redo | binlog / relay log |
10. WAL 与 Checkpoint 流程(ARIES 恢复原理)
10.1 WAL 记录长什么样
- WAL 是逻辑+物理混合的重做日志:记录”对某页某个偏移做了什么修改”(redo),并在 commit 时刻写一条 commit 记录。
- 写入路径:
backend改共享缓冲页 → 先把 WAL 记录写进 WAL 缓冲区 →walwriter按wal_writer_delay(默认 200ms)或 commit 时fsync落pg_wal/。 - WAL 先于数据页落盘(WAL 永不落后于脏页刷盘),这是崩溃恢复成立的前提。
10.2 LSN 与 WAL 段
- 每条 WAL 有唯一
LSN(Log Sequence Number),8 字节逻辑偏移,显示成0/16B2D48。 - 段文件命名:
TLI(时间线,8位) + 逻辑高32位(8位) + 低32位(8位),默认每段 16MB。 - 三个关键”位点”:
redo:上一次 checkpoint 开始的重做起点(pg_control里)。insert:当前已写入的 WAL 末尾。recycle/remove:旧段在 checkpoint 后可被循环复用(max_wal_size控制上限)。
10.3 Checkpoint 做了什么
触发条件:checkpoint_timeout(默认 5min)、WAL 量到 max_wal_size、手动 CHECKPOINT;、关机/Promote。
一次 checkpoint 顺序:
- 写 checkpoint 记录到 WAL(记录当前 redo 起点)。
- 把
shared_buffers里所有脏页批量刷到数据文件(由bgwriter平时渐进刷,checkpoint 负责兜底)。 - 刷
clog(事务提交状态)、依赖文件。 - 把新 redo 起点写回
pg_control。 - 标记旧 WAL 段可回收/归档。
关键参数(生产调优):
| 参数 | 默认 | 说明 |
|---|---|---|
shared_buffers | 128MB | 建议物理内存 25%(Linux 注意 transparent_hugepage) |
wal_buffers | -1(≈ shared_buffers 的 1/32,≈16MB) | 高并发写可调到 64MB |
checkpoint_timeout | 5min | 调到 10~15min 减少刷盘抖动 |
max_wal_size | 1GB | 调到 4~16GB,给 checkpoint 留余量、避免频繁 recycle |
min_wal_size | 80MB | 保持循环复用区,避免 WAL 频繁扩缩 |
checkpoint_completion_target | 0.9 | 把刷脏页摊到整个 checkpoint 周期,削峰 |
wal_buffers/synchronous_commit | on | 高可用可保留 on;极致性能可权衡 off/remote_apply |
10.4 崩溃恢复(Startup 进程)
实例拉起时:
- 读
pg_control,拿到上次 checkpoint 的 redo 起点checkpointRedo。 - 从该 LSN 重放(redo)所有 WAL:把当时被改过的页重新应用一遍——即使数据页已经脏写过也没关系(幂等重放)。
- 处理 commit/abort:已 commit 的事务生效,未 commit 的回滚(undo 靠 tuple 版本标记,不是独立 undo 段)。
- 恢复到一致状态后开始接受连接。
11. VM / FSM 与 VACUUM 机制(物理文件如何被”维护”)
11.1 为什么需要 VACUUM
PG 是 MVCC 多版本:UPDATE/DELETE 并不原地删旧元组,而是留 dead tuple(死亡版本),靠 xmin/xmax 事务号判断可见性。dead tuple 会膨胀、占空间、拖慢扫描,必须回收——这就是 VACUUM。
11.2 Visibility Map(VM,_vm)
- 每 8KB 页对应 VM 里一个 bit,标记”该页对所有当前及未来事务都可见(没有任何 dead tuple、全可见)”。
- 作用:
- Index-Only Scan:索引回表时若 VM 标记页全可见,就不用再回堆表取可见性。
- VACUUM 跳过全可见页:
autovacuum直接跳过 VM 置位的页,大幅省 IO。
- VM 由第一次全表扫描时的 hint-bit 写和 VACUUM 共同维护。
11.3 Free Space Map(FSM,_fsm)
- 记录每个页还剩多少可用空间(按二叉树密度组织)。
- 作用:INSERT/UPDATE 找”还有空位的页”时,直接查 FSM,而不是顺序扫描整个表。
- FSM 不自动收缩成 0;
VACUUM回收 dead tuple 后更新空闲信息;VACUUM FULL/CLUSTER重写物理文件才真正缩小尺寸。
11.4 VACUUM 家族
| 命令 | 做什么 | 锁 | 是否收缩文件 |
|---|---|---|---|
VACUUM | 标记 dead tuple 可复用、更新 FSM、统计信息 | 不阻塞 DML(share update exclusive) | 否,文件不变小 |
VACUUM FULL | 整表重写、压缩、重建索引 | 排他锁(AccessExclusive),阻塞读写 | 是,文件物理缩小 |
VACUUM ANALYZE | VACUUM + 采样更新统计信息(优化器用) | 同 VACUUM | 否 |
VACUUM (INDEX_CLEANUP) | 控制是否清理死亡索引元组 | 同 VACUUM | 否 |
11.5 autovacuum 与 XID 回卷(Wraparound)
- PG 事务 ID 是 32 位计数器,用完会强制 autovacuum(防止 XID 回卷覆盖仍可见的旧元组)。
- 关键监控:
age(datfrozenxid)接近autovacuum_freeze_max_age(默认 2 亿)时会触发激进 freeze。 - 常用排查:
SELECT datname, age(datfrozenxid) FROM pg_database ORDER BY 2 DESC; SELECT relname, n_dead_tup, n_live_tup, last_autovacuum FROM pg_stat_user_tables ORDER BY n_dead_tup DESC LIMIT 10;
12. PostgreSQL 17.11 编译参数调优(BLCKSZ / WAL 段大小)
适用:你从源码编译部署(之前记录过 17.11 编译排错)。这些参数在 initdb 时定,事后不可改(改了要整库重建),所以必须在初始化前规划。
12.1 页大小 BLCKSZ(--block-size)
- 默认 8KB。
- 编译选项:
./configure --block-size=8(单位 KB),可设 4/8/16/32。 - 怎么选:
- OLTP 小事务:保持 8KB 最稳妥,缓存命中、WAL 放大均衡。
- 数仓/宽行/大 JSON:16KB 可减少跨页行、提升顺序扫描;但单行若超过页大小 1/4 会走 TOAST,且 WAL 放大更明显。
- 4KB:适合极度随机小 IO、flash 对齐,但行效率低,一般不选。
- ⚠️ 改 BLCKSZ 是集群级不可逆,
pg_controldata里能看到Block size。
12.2 WAL 段大小(--wal-segsize)
- 单位 MB,默认 16,范围 1~1024(1GB)。
- 编译/initdb:
./configure --with-wal-segsize=16,或initdb --wal-segsize=64。 - 怎么选:
- 高写入/大库:64~256MB,减少段文件数量、降低 checkpoint 时段循环/归档的开销(注意
max_wal_size要相应放大,否则段数太少达不到缓冲)。 - PITR 频繁归档:段太大单次归档块大,恢复粒度粗;段太多则
pg_wal目录文件数爆炸。
- 高写入/大库:64~256MB,减少段文件数量、降低 checkpoint 时段循环/归档的开销(注意
- 生产常见组合:
--block-size=8 --wal-segsize=64,配合max_wal_size=8GB。
12.3 其他编译期可调项(相关)
| 选项 | 说明 |
|---|---|
--with-blocksize / --with-wal-blocksize | 表页 / WAL 页大小(WAL 页默认 8KB,一般不动) |
--enable-debug / --enable-cassert | 调试版,生产别开 |
--with-ssl=openssl | OpenSSL 支持 |
--with-python/--perl/--libxml | 扩展语言支持 |
CC='gcc' CFLAGS='-O2 -march=x86-64-v3' | 按 CPU 架构优化(你之前 17.11 排错时依赖) |
12.4 初始化后核对
# 编译/初始化后确认页大小与 WAL 段
pg_controldata $PGDATA | findstr /I "block size WAL segment"
# 输出示例:
#   Data page size                       8192
#   WAL block size                       8192
#   WAL segment size                     67108864   (64MB)
13. PostgreSQL 18.x 物理架构相关变更(18.0 大版本 + 18.6 维护版)
你当前编译的是 17.11,这里把升到 18.x 时物理/存储层要知道的变化单独列出。
注意:18.6 本身是维护版本(2026-08-13),不引入新特性;真正的物理层大改来自 18.0(2025-09-25)。
13.1 18.0 大版本:AIO 异步 I/O 子系统(物理运行时最大变化)
- 引入全新的 Asynchronous I/O (AIO) 子系统,backend 可以一次性并发提交多个读请求,而不是逐个阻塞等待。
- 受益操作:顺序扫描(seq scan)、位图堆扫描(bitmap heap scan)、VACUUM 等,官方基准从存储读取性能最高提升约 3 倍。
- 相关 GUC(18.0 新增): 参数 作用
io_method选择 I/O 方式(sync/io_uring等,Linux 下建议io_uring)io_combine_limit单次合并 I/O 请求上限io_max_combine_limit合并上限的硬顶 - 其他大版本相关:
pg_upgrade现在保留优化器统计信息(升级后不用立即全库 ANALYZE);支持多列 B-tree 的 skip scan。 - 编译侧:18.x 建议用较新 Linux 内核(
io_uring需 kernel ≥ 5.1,推荐 5.15+),否则自动退回 sync。
13.2 18.6 维护版:与物理架构直接相关的关键修复
这些修复都直接改在本笔记讲过的机制上,升级到 18.6 时建议重点关注。
| 修复点 | 对应笔记章节 | 影响 |
|---|---|---|
| VM 位图清除位的 WAL 记录被遗漏(WAL summarizer 没记录这类 VM 变更) | §10 WAL / §11 VM | 增量备份(incremental backup)可能基于错误的 VM 状态;且这类 VM 页在需要时没写全页镜像(FPI),torn page 无法被 redo 纠正,可能导致 index-only scan 返回错误结果 |
| VACUUM wraparound failsafe 模式下恢复共享缓冲池完整使用 | §11.5 回卷 | v18 重构时误把 failsafe 模式也限制在少量 shared buffer,导致防回卷 freeze 变慢;18.6 恢复”紧急时不限 buffer”的原设计 |
| 批量扩展表时最后一个块未及时写入 FSM(off-by-one) | §4 FSM | 多块扩展的表最后一个块长期不被 FSM 标记为空闲,空间暂时浪费,直到 VACUUM 才纠正 |
| autovacuum 处理数据库的顺序颠倒 | §11.5 autovacuum | 原本应按分数从高到低挑库,18.x 误成从低到高,18.6 纠正 |
| 并行 VACUUM worker 进度报告内存泄漏(每次报告漏 ~1kB) | §11.4 VACUUM | 长时间运行的并行 vacuum worker 进程内存缓慢累积 |
| 临时表访问限制 local buffer 数量 | §7 共享内存 | 之前 effective_io_concurrency 过大时,单条读流可能耗尽所有本地 buffer,报”no empty local buffer available”;18.6 加了上限 |
GIN 并行索引构建错误更新 pg_class.reltuples(可能出现 Infinity/NaN) | §11.5 统计 | 会导致 autovacuum / autoanalyze 错误地判断该表不需要处理,且不自愈;升级后需对含 GIN 索引的表手动 ANALYZE 或重建索引 |
| WAL summarizer 在 timeline switch(主备切换)时卡住 | §10.2 LSN/TLI | 备机提升时间线后 summarizer 进程挂起,18.6 修复 |
13.3 18.6 安全修复(升级建议,与物理层无关但必须打)
- 新增 GUC
output_plugin_libraries:限制逻辑解码可加载的输出插件(默认只放行pgoutput、test_decoding),第三方插件需手动加入。 - 主要 CVE:CVE-2026-14662(tsvector/tsquery 整数回绕)、CVE-2026-18024(
ascii()越界读)、CVE-2026-18408(pg_dump 恢复时命令注入)、CVE-2026-19385(pg_dump 内存越界)、CVE-2026-14676(pg_stat_statements 缓冲越界)等。 - 扩展重建建议:装完 18.6 后,若用了
btree_gist(float/bit 列、!=操作)或ltree(>14653 标签),建议 REINDEX 相关索引。 - 构建侧:支持 OpenSSL 4。
13.4 从 17.11 升到 18.6 的物理层注意清单
- 内核版本:生产启
io_uring需 kernel ≥ 5.1(建议 5.15+),否则保持io_method=sync。 - 升级后检查含 GIN 索引表的
pg_class.reltuples,异常就ANALYZE。 - 用了
btree_gist/ltree的库升级后 REINDEX。 - 逻辑解码用了第三方输出插件的,在
output_plugin_libraries里显式放行。 - 依赖增量备份(
pg_combinebackup/ WAL summarizer)的环境,强烈建议升到 18.6(VM 漏记是数据正确性 bug)。 pg_upgrade后统计信息保留,不必立即全库 ANALYZE,但大表首次查询前可按需手工收集。
14. 从 17.11 原地升级到 18.6(pg_upgrade 物理操作步骤)
适用:同一台机器、
pg_upgrade二进制原地替换数据目录(不 dump/restore)。
前提:大版本跨号升级(17→18),小版本(18.4→18.6)直接替换二进制即可,不需要 pg_upgrade。
14.1 升级前检查清单(必做)
- 确认大版本兼容:17→18 支持原地升级;17.x 的小版本必须 ≥ 最低要求(建议 17.4+,你是 17.11 满足)。
- 架构/编译选项必须一致:
- 相同字节序、相同
--block-size(BLCKSZ)、相同--wal-segsize。 - 相同
--integer-datetimes(18 已强制开启,17 默认也是,一致)。 - 相同安装架构(32/64 位)。
- 相同字节序、相同
- 备份:
pg_dumpall逻辑备份 +pg_basebackup物理备份(或tar冷备整个$PGDATA和所有表空间目录)。 - 停应用:确认无业务连接。
- 检查扩展:记录所有
CREATE EXTENSION,升级后逐个ALTER EXTENSION ... UPDATE;特别是 18.6 提到的btree_gist、ltree、pg_trgm、fuzzystrmatch。 - 检查 64 位时间戳:18 只支持 64 位 timestamp(17 默认已开启,无问题)。
- 磁盘空间:新 18.6 安装目录 + 旧数据目录保持不动;
pg_upgrade不复制整库,但需要足够临时空间写日志。
14.2 部署 18.6 二进制
# 假设编译安装目录约定
# 旧版 17.11:/usr/local/pgsql/17
# 新版 18.6 :/usr/local/pgsql/18
cd /opt/src/postgresql-18.6
./configure --prefix=/usr/local/pgsql/18 \
  --block-size=8 \
  --wal-segsize=16 \
  --with-openssl --with-python --with-libxml \
  CC='gcc' CFLAGS='-O2 -march=x86-64-v3'
make -j$(nproc)
make install
# 编译 contrib(你用到的扩展)
cd contrib && make && make install
⚠️ 不要让新旧二进制共用
bin/、lib/、share/目录,必须分目录。
14.3 停旧库、做冷备
# 停 17.11
systemctl stop postgresql-17
# 或 su - postgres -c '/usr/local/pgsql/17/bin/pg_ctl -D /pgdata/17 stop -m fast'

# 物理冷备(关键:保留回滚路径)
tar -czf /backup/pgdata-17-$(date +%F).tar.gz /pgdata/17
# 表空间目录也要打包(pg_tblspc 是软链,实际目录在外面)
tar -czf /backup/tblspc-17-$(date +%F).tar.gz /data/pg_ts/
14.4 执行 pg_upgrade(核心)
# 用 postgres 用户,建议新建一个空工作目录跑
mkdir -p /tmp/pg_upgrade && cd /tmp/pg_upgrade

/usr/local/pgsql/18/bin/pg_upgrade \
  --old-datadir /pgdata/17 \
  --new-datadir /pgdata/18-init \
  --old-bindir /usr/local/pgsql/17/bin \
  --new-bindir /usr/local/pgsql/18/bin \
  --jobs $(nproc) \
  --check          # 第一步先加 --check 只做预检,不改动
预检通过后去掉 --check 正式跑:
# 先 initdb 一个新空目录(pg_upgrade 不会自动建)
/usr/local/pgsql/18/bin/initdb -D /pgdata/18-init \
  --encoding=UTF8 --locale=C \
  --block-size=8 --wal-segsize=16 \
  -U postgres

# 正式升级
/usr/local/pgsql/18/bin/pg_upgrade \
  --old-datadir /pgdata/17 \
  --new-datadir /pgdata/18-init \
  --old-bindir /usr/local/pgsql/17/bin \
  --new-bindir /usr/local/pgsql/18/bin \
  --jobs $(nproc) \
  --link            # ← 关键:硬链接模式,秒级完成;不复制数据文件
--link vs 缺省:
--link:新旧数据文件硬链接共享同一个 inode,升级快、不占额外空间;但一旦 link 后不能再回退到 17(数据已被新格式改写元数据)。生产推荐先备份再用--link。- 不带
--link:完整复制数据文件,耗时长、占双倍空间;优点是旧目录保持原样可回退。
14.5 升级后的物理文件变化
pg_upgrade 完成后:
- 新
$PGDATA(/pgdata/18-init)里:global/、base/、pg_wal/等目录已被切换成 18 格式;- 用
--link时,base/<dbOID>/下的 relfilenode 数据文件和旧目录是同一 inode(硬链接); pg_control已更新为 18 格式;postgresql.conf从旧配置复制过来(需手动补 18 新增参数)。
- 表空间:
pg_tblspc/下的软链指向实际目录,目录里多了一个PG_18_xxx/子目录(按版本+DB OID 组织)。 - 旧目录
/pgdata/17在--link模式下不要立刻删,确认新库跑稳后再删(delete_old_cluster.sh脚本会自动生成)。
14.6 启动新库并收尾
# 1. 先把配置文件对齐
cp /pgdata/17/postgresql.conf /pgdata/18-init/   # 或手工合并,补 io_method 等新参数
cp /pgdata/17/pg_hba.conf /pgdata/18-init/

# 2. 启动 18.6
/usr/local/pgsql/18/bin/pg_ctl -D /pgdata/18-init -l /tmp/pg18.log start

# 3. 按 pg_upgrade 屏幕提示跑生成的脚本
#    它会:(a) 升级统计信息 (b) 迁移 froze 状态
./analyze_new_cluster.sh      # 18 起 pg_upgrade 保留统计,这步主要做收尾
./delete_old_cluster.sh       # 确认无误后再跑,删除旧 17 数据
必须手动做的收尾 SQL:
-- 1. 升级所有扩展
\c postgres
SELECT extname, extversion FROM pg_extension;
ALTER EXTENSION plpgsql UPDATE;
ALTER EXTENSION btree_gist UPDATE;
ALTER EXTENSION ltree UPDATE;
ALTER EXTENSION pg_trgm UPDATE;
ALTER EXTENSION pg_stat_statements UPDATE;
-- 其他扩展同理

-- 2. 检查 GIN 表 reltuples(18.6 修复项)
SELECT relname, reltuples FROM pg_class
WHERE relkind='r' AND reltuples < 0 OR reltuples = 'Infinity'::float;
-- 异常就 ANALYZE 对应表

-- 3. 配置 18 新增 AIO(在 postgresql.conf)
-- io_method = io_uring          # Linux 内核 ≥5.15 建议开
-- io_combine_limit = 128
14.7 升级后验证清单
# 版本与控制文件
/usr/local/pgsql/18/bin/pg_controldata /pgdata/18-init | grep -E "Version|cluster"
psql -c "SELECT version();"
psql -c "SHOW server_version;"

# 关键对象数量核对(升级前后应一致)
psql -c "SELECT count(*) FROM pg_class WHERE relkind='r';"
psql -c "SELECT datname, pg_size_pretty(pg_database_size(datname)) FROM pg_database;"

# 表空间路径
psql -c "\db+"
ls -l /pgdata/18-init/pg_tblspc/

# AIO 是否生效(18 新参数)
psql -c "SHOW io_method;"
psql -c "SHOW io_combine_limit;"
14.8 回滚方案(没用 --link 才可行)
- 没用
--link:直接停 18,用旧的/pgdata/17启动 17 二进制即可。 - 用了
--link:数据文件已被 18 改写元数据,不能回退到 17;只能靠冷备tar包恢复,或从 18 库pg_dumpall后重建 17。 - 建议:生产环境先用一台同版本测试库演练,确认无误再上生产;
--link模式前必须确认备份可用。
15. 一句话总结
PostgreSQL 物理架构 = 一个
$PGDATA数据区,里面用base/<dbOID>/把每个库物理隔开;库里每张表用一个数字 relfilenode 文件存堆数据,并配一个 FSM(空闲映射)和一个 VM(可见性映射);global/管聚簇元数据,pg_wal/靠 WAL→checkpoint→崩溃恢复支撑持久性与流复制,pg_tblspc/用软链把表/对象放到自定义磁盘路径。页大小与 WAL 段在编译/initdb 时定死。18.0 起新增 AIO 异步 I/O 子系统(io_method=io_uring)提升扫描/vacuum 吞吐;18.6 则修复了 VM 漏记 WAL、FSM off-by-one、vacuum failsafe buffer 限制等物理层正确性问题。跨大版本升级用pg_upgrade --link硬链接模式秒级完成,但需先冷备、编译选项一致、升级后扩展逐个 UPDATE。